
案件在海域、内河和港区如何分布?
第一轮比较打捞案件的发生水域。公开案例共列出 108 起,其中海域 80 起,占 74.1%,内河及港区合计 28 起。
这组数量为后续按距离、事件类型和所用资源进行分析提供了基准。来源栏另显示查询结果为 107 行。回查明细时,要分别核对 108 起案件的聚合规则和 107 行记录的范围。
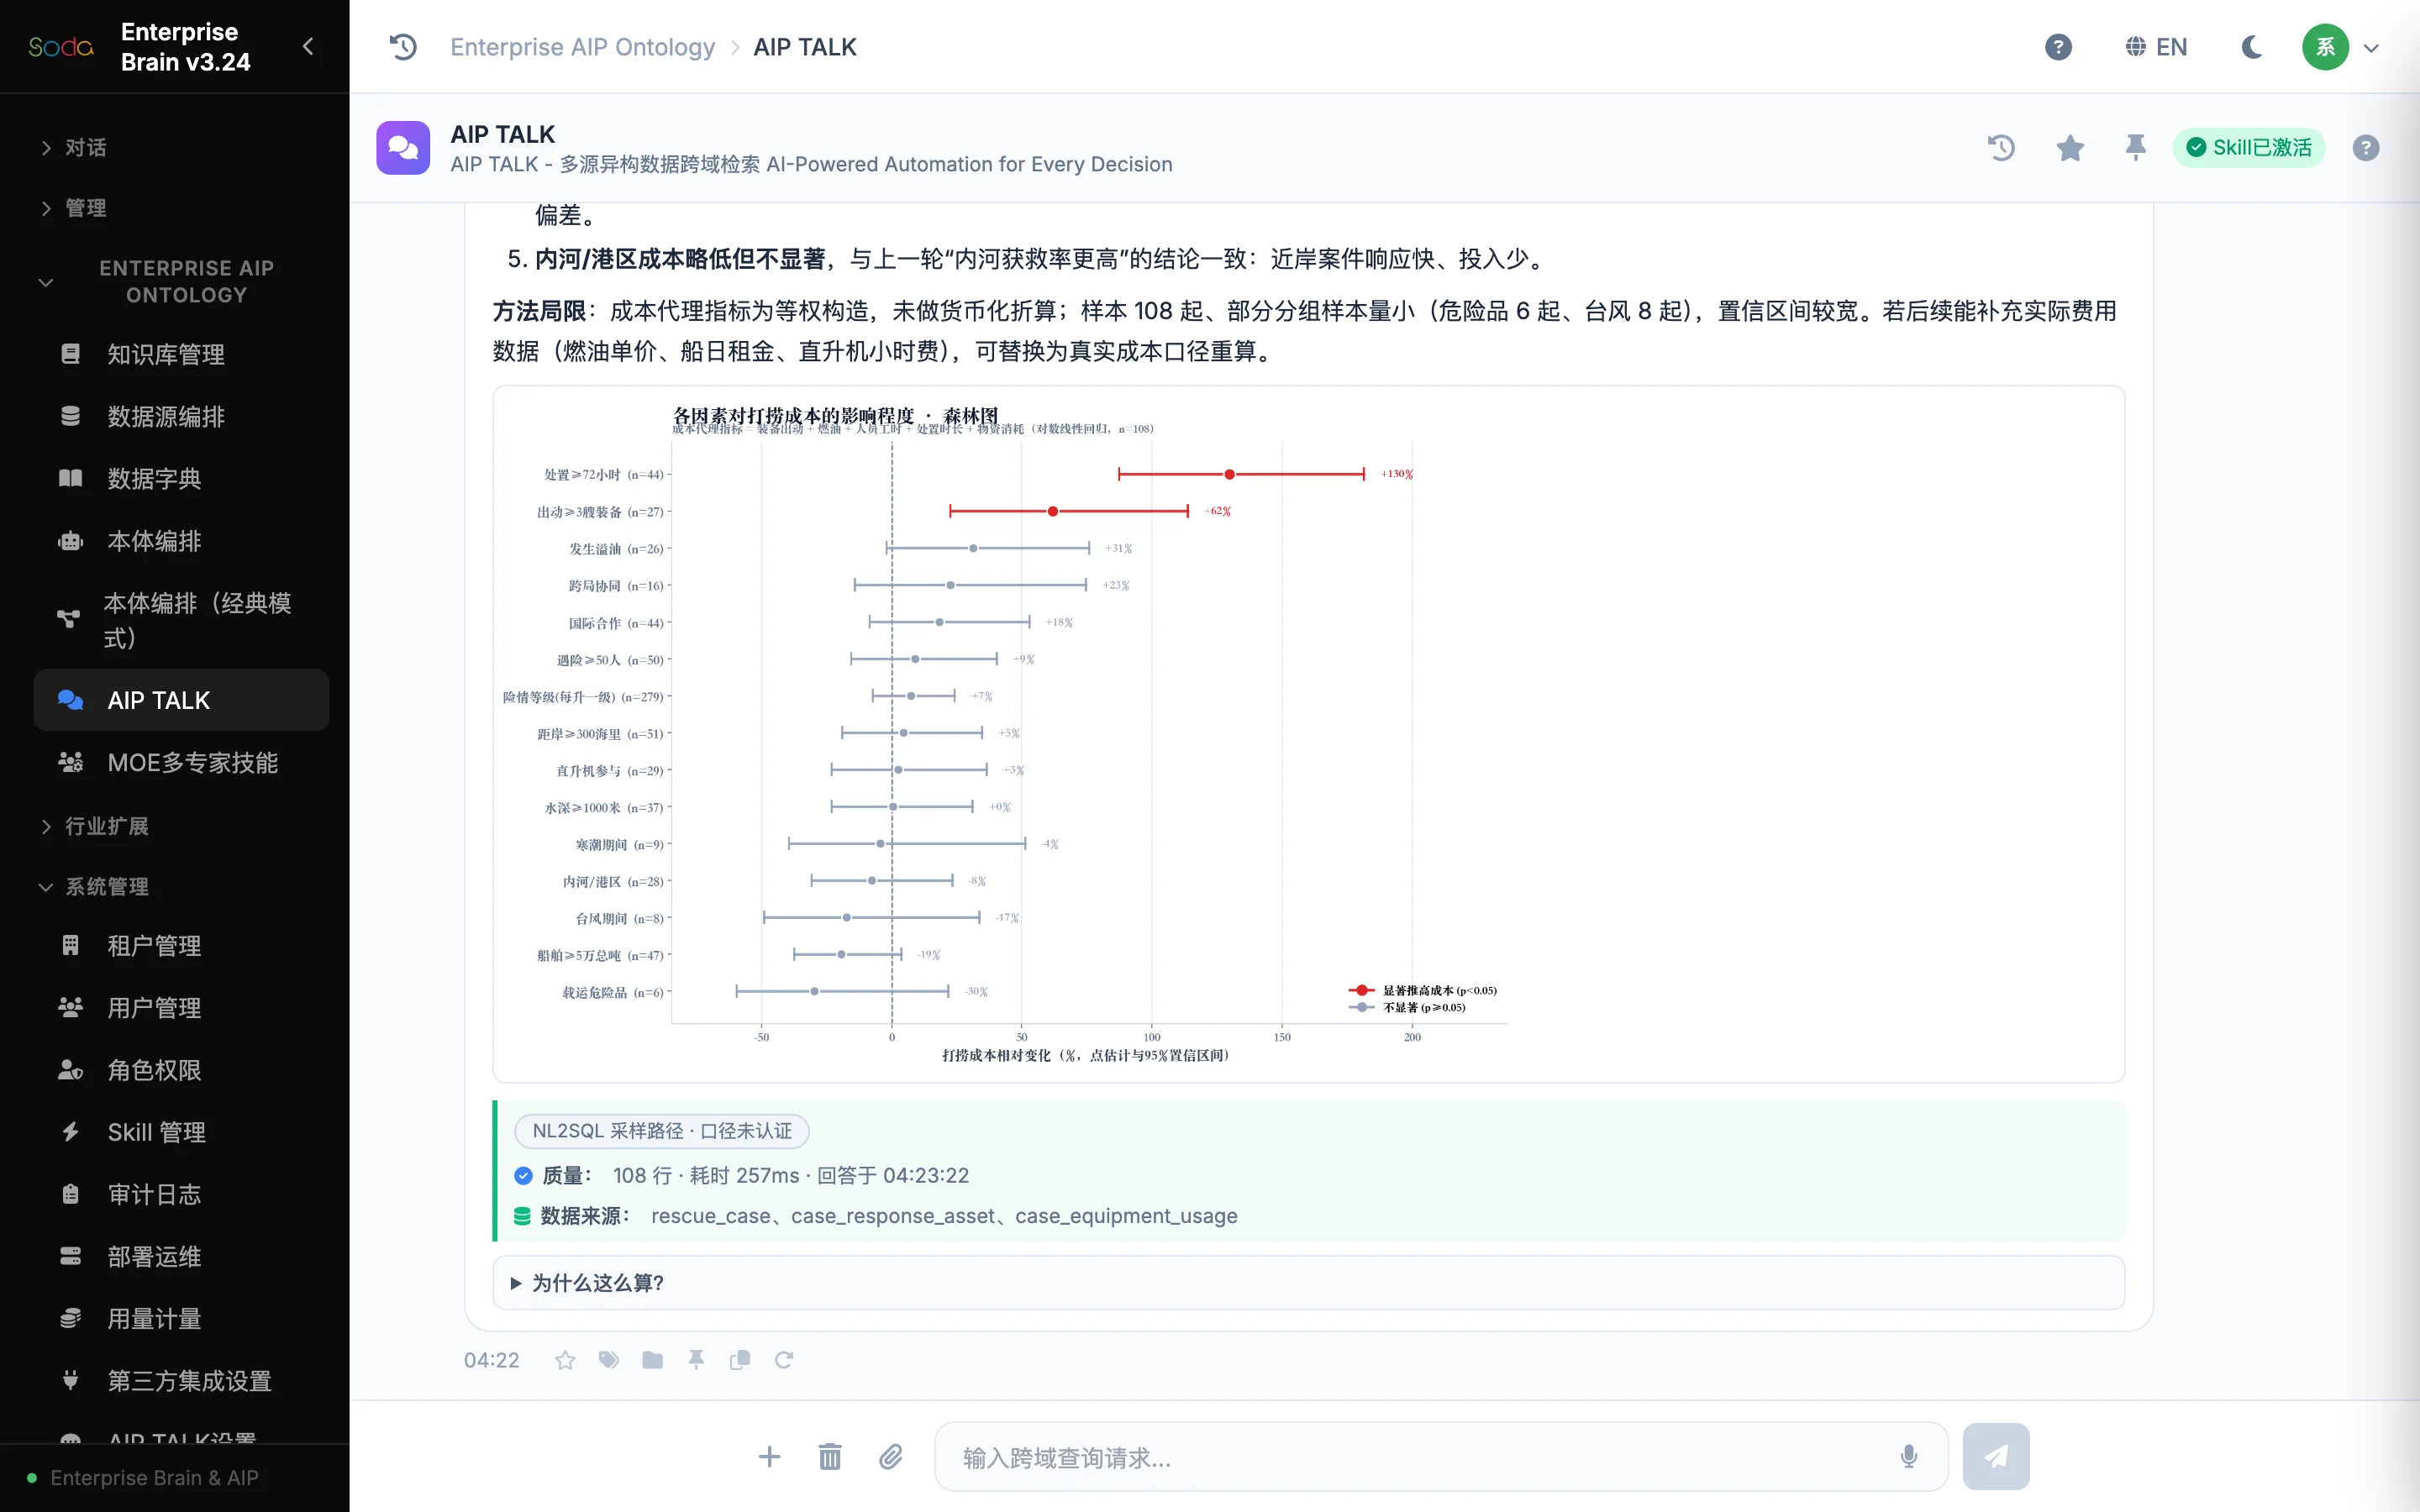
“用森林图对比成本影响因素。”把估计值与不确定性放在一起
第二轮要求用森林图比较各因素对打捞成本的影响。实拍显示了点估计与 95% 置信区间,处置时间达到 72 小时、出动装备达到 3 艘的分组,在该次分析中分别对应约 +130% 和 +62% 的相对变化,其他因素的不确定性也在图上保留。
图上使用的是等权构造的成本代理指标,尚未折算燃油单价、船舶租金和直升机小时费。它用于发现值得研究的资源消耗因素;这些百分比不能直接解释为真实人民币成本涨幅。部分分组样本较小、区间较宽,也会影响结论的稳定程度。
“哪些案件属于重大事故?”先核对人工标签与筛选口径
第三轮原问要求按重大海事事故认定标准筛查案件。产品将库内人工标注的险情等级与引用的统计规则进行比较,发现二者不完全一致,说明直接使用已有等级标签可能遗漏需要复核的条目。
实拍同时出现 24 起与 25 起两个结果:文字使用死亡人数筛选,表格使用死亡与失踪人数合计筛选。案例保留这种口径差异,帮助使用者回到字段、适用规则与原始记录核查;这些输出是待复核的查询结果,本页不将其写成正式事故等级认定。
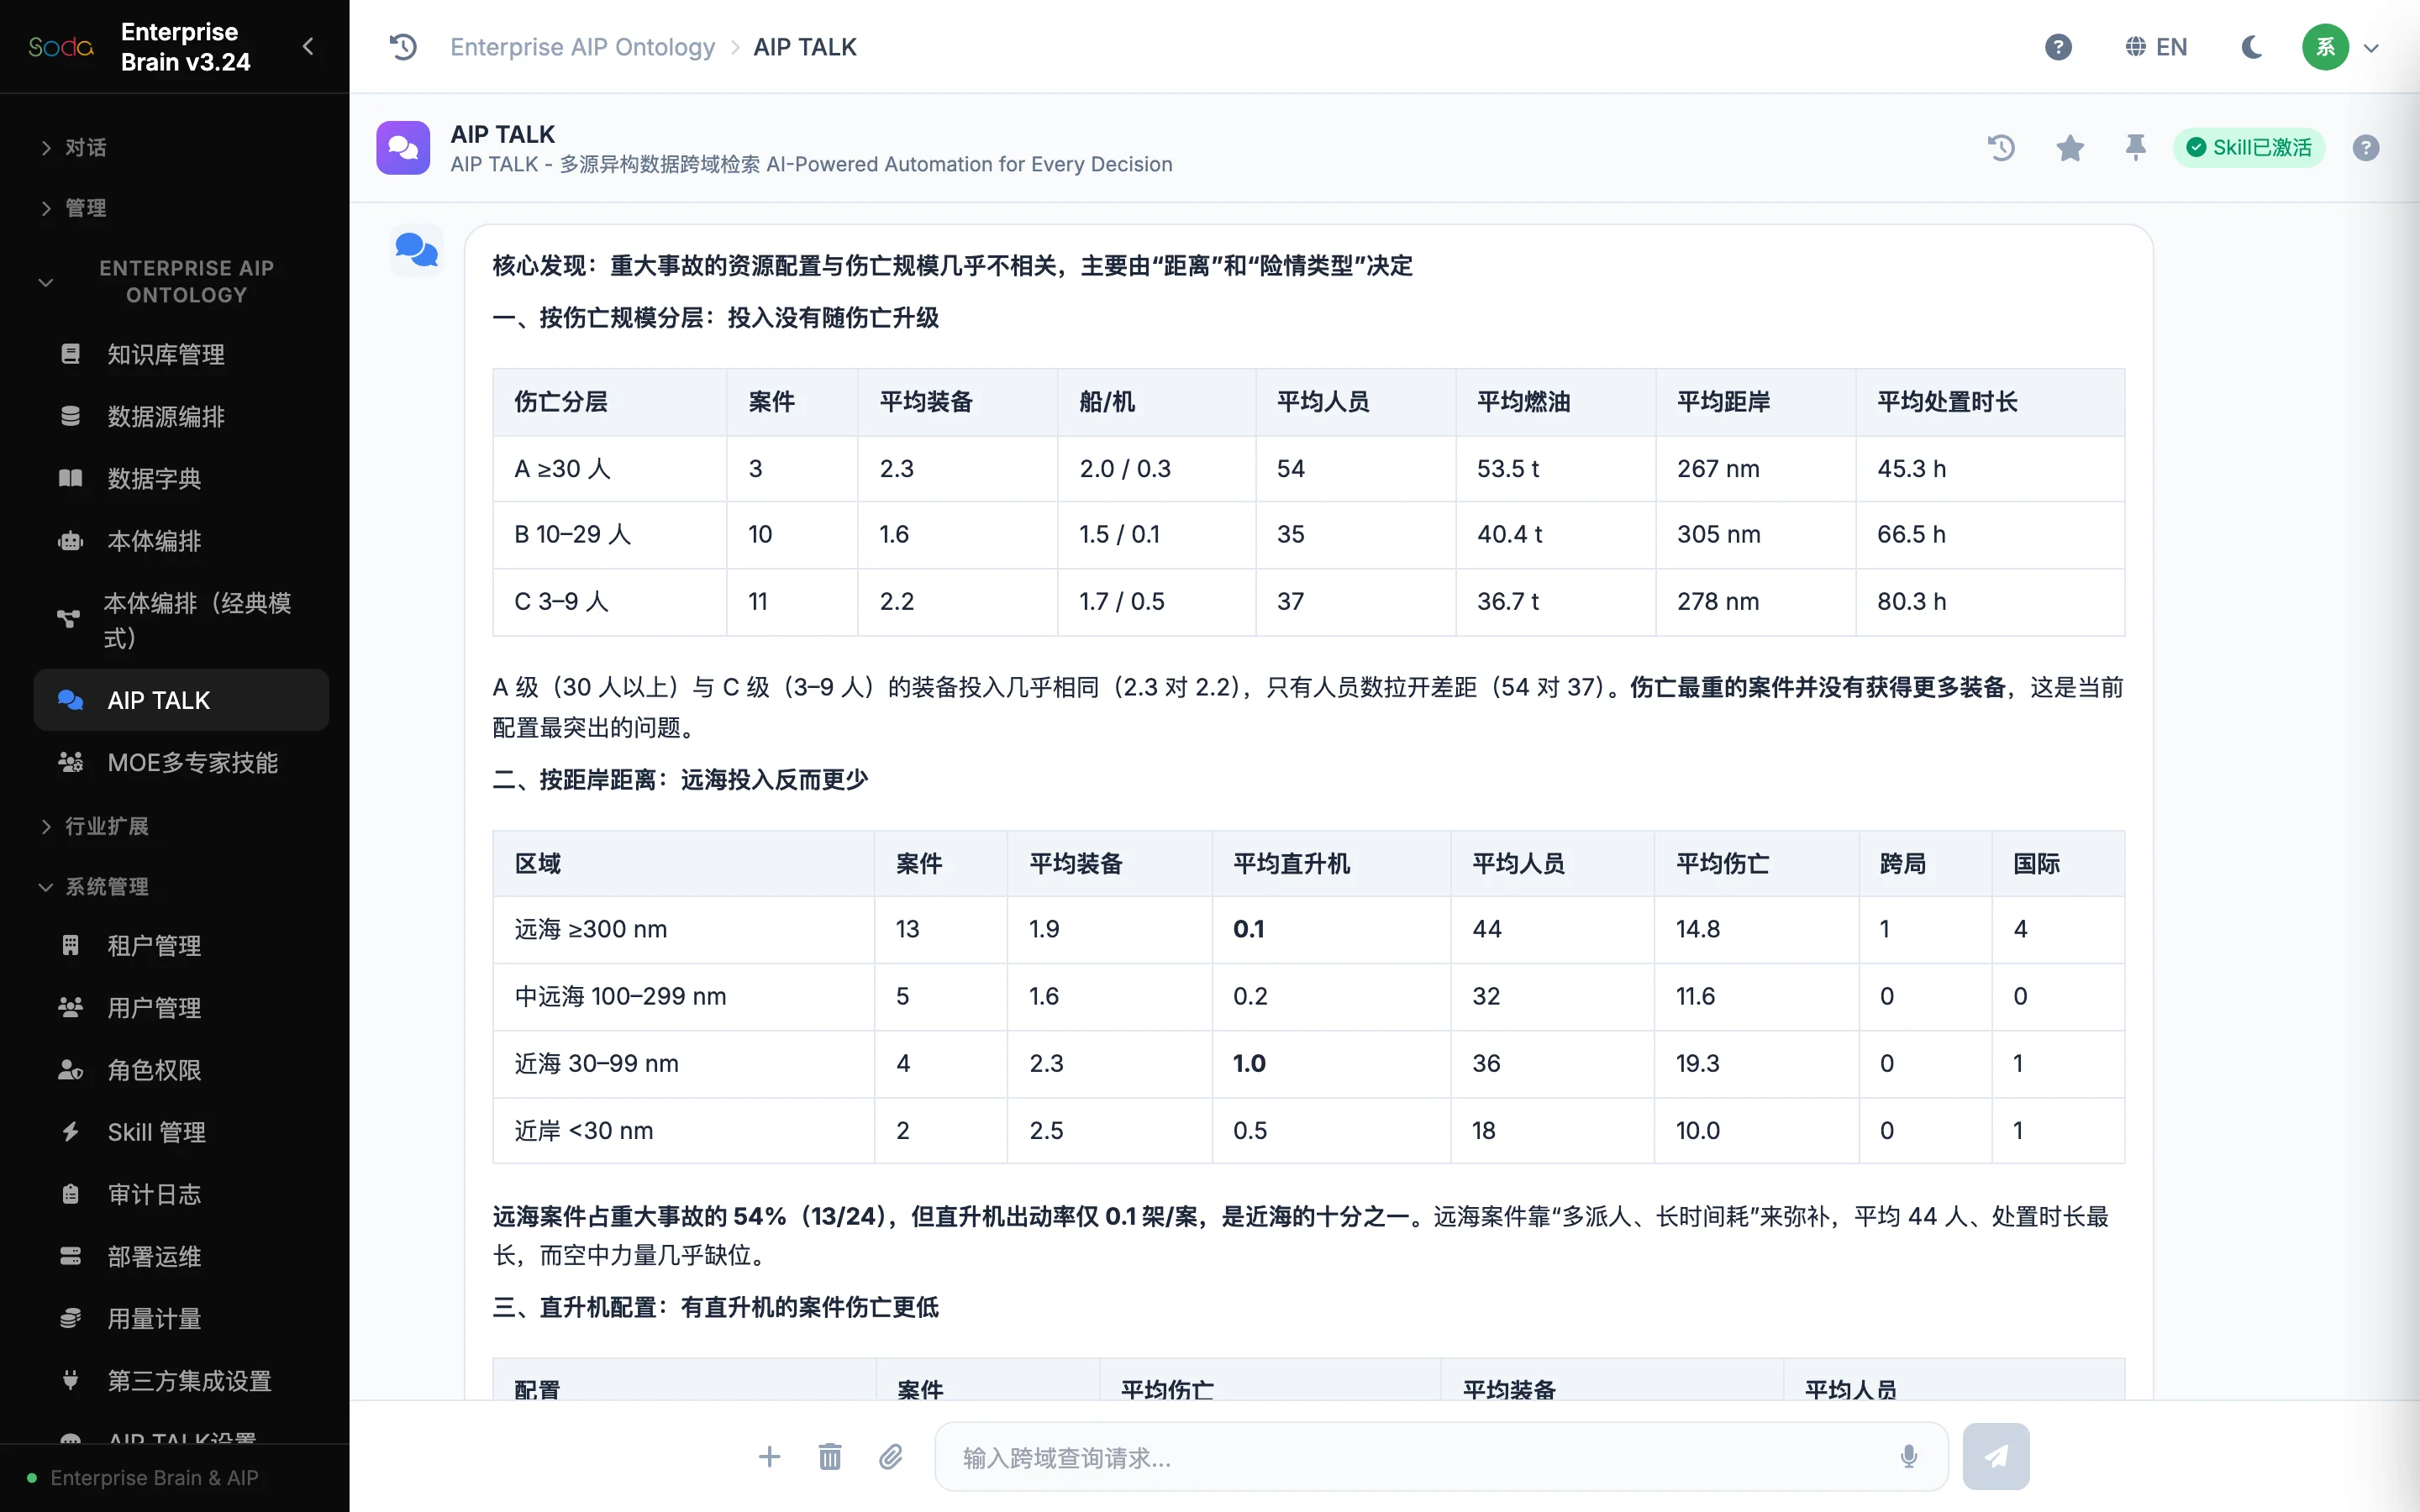
“这些案件的资源配置有什么规律?”按距离与事件规模分层
第四轮把筛出的案件继续按伤亡规模和离岸距离分层,比较装备、船机、人员、燃油与处置时长。后续资源表使用 24 起子样本,其中离岸至少 300 海里的远海案件为 13 起,约占 54%;远海组平均直升机出动为 0.1 架/案,近海组为 1.0 架/案。
实拍还观察到,不同伤亡规模分组的装备投入没有同步增加。这个结果引出对资源可达性、距离和险情类型的进一步讨论,但不能仅凭分组均值判断某起事故应投入多少装备,也不能由此认定某项配置导致了伤亡结果。
把分析线索转成资源规划议题
原回答结合远海案件占比、空中力量使用和处置时长,提出研究远海空中力量前置部署的建议。复盘时,业务处室可以逐组比较距离与装备投入,再补查各区域的实际费用和可用运力。
后续规划需要结合装备可用性、航程、气象海况、协同条件及最新任务信息,由专业团队评估。案例呈现的是历史样本上的分析与规划线索,现场调度仍由具备职责的指挥流程决定。
每一步分析用了哪些案件?
产品实拍的来源栏列出了查询的数据表和结果记录。读者可以沿出处回查,确认哪些结论覆盖全部案件,哪些只适用于经过筛选的子样本。
水域分布汇总了 108 起案件。两种重大事故筛选口径分别得到 24 起和 25 起,资源复盘采用 24 起。复核成本因素时,还需沿用原分析对成本代理指标的定义,才能比较各组的估计值。